向量检索
基于 pgvector 的相似度检索,适合语义相近但用词不同的提问。
同一份 PDF 里可能既有文字层又有扫描页。MossKB 逐页判断,把能直接抽取的交给程序,把需要识别的交给 OCR。
| 文档情况 | 解析路径 |
|---|---|
| 文字型 PDF | 直接抽取文本与结构,不消耗 OCR 额度 |
| 本地结构化文件 | 按格式就地提取,保留标题与段落关系 |
| 扫描页 / 图片 | 交给远程 OCR 模型识别,默认 PaddleOCR-VL-1.5 |
| 混合 PDF | 逐页检测,逐页选择上面的路径 |
| 在线网页 | 抓取正文并清理导航、页脚等噪声节点 |
向量维度必须与知识库创建时选择的模型一致:默认 Qwen3-Embedding-8B 返回 1024 维。已有文档的知识库不能直接切换向量空间,需要新建知识库并重新导入。
三种检索模式在应用里可切换,底层的向量索引与全文索引都在同一套 PostgreSQL 里。
基于 pgvector 的相似度检索,适合语义相近但用词不同的提问。
基于 pg_trgm 的文本匹配,适合编号、名称、专有名词必须命中的情况。
两种结果融合排序,兼顾语义召回与字面命中,是默认推荐模式。
文档与查询使用知识库选定的同一个向量模型;模型权重不必在本机,指向兼容的远程 embeddings 服务即可,也支持替换为离线部署的向量模型。
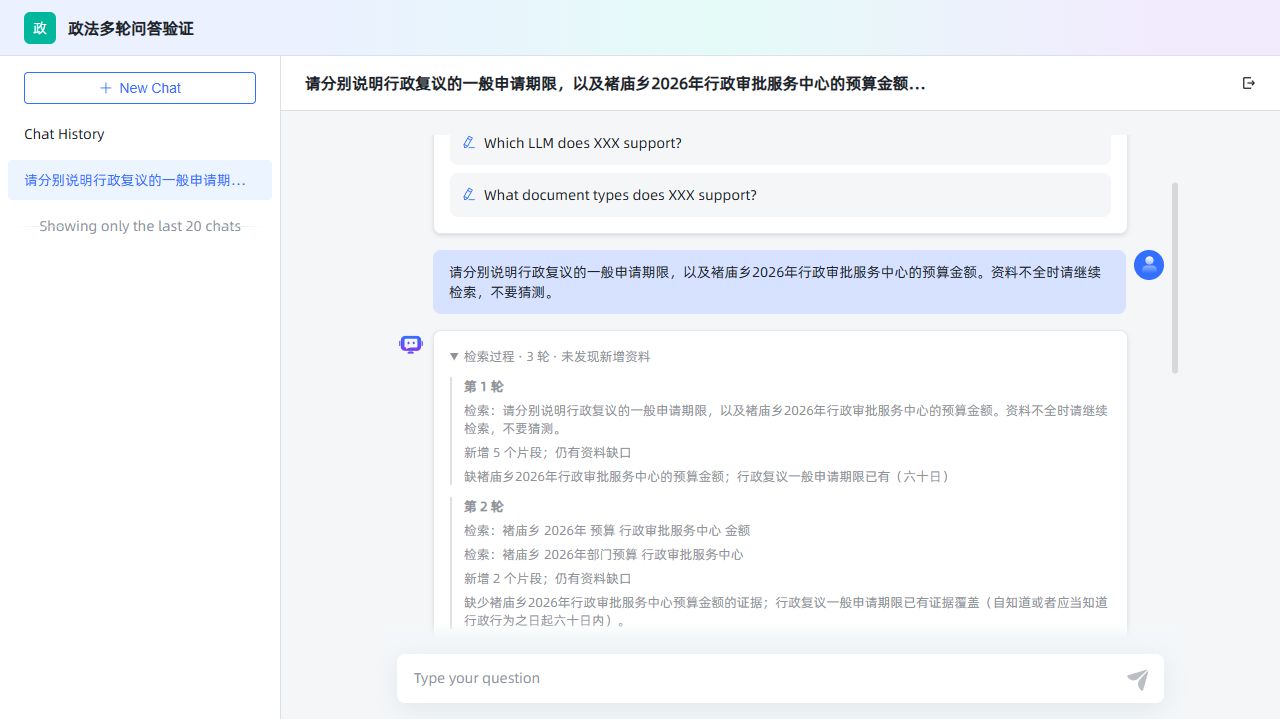
普通 RAG 只检索一次,资料不足时模型只能硬答。MossKB 让同一次提问内部多走几轮。
界面上能看到每一轮用到的检索词、新增片段数,以及仍然缺失的资料,排查「为什么答错了」不再靠猜。
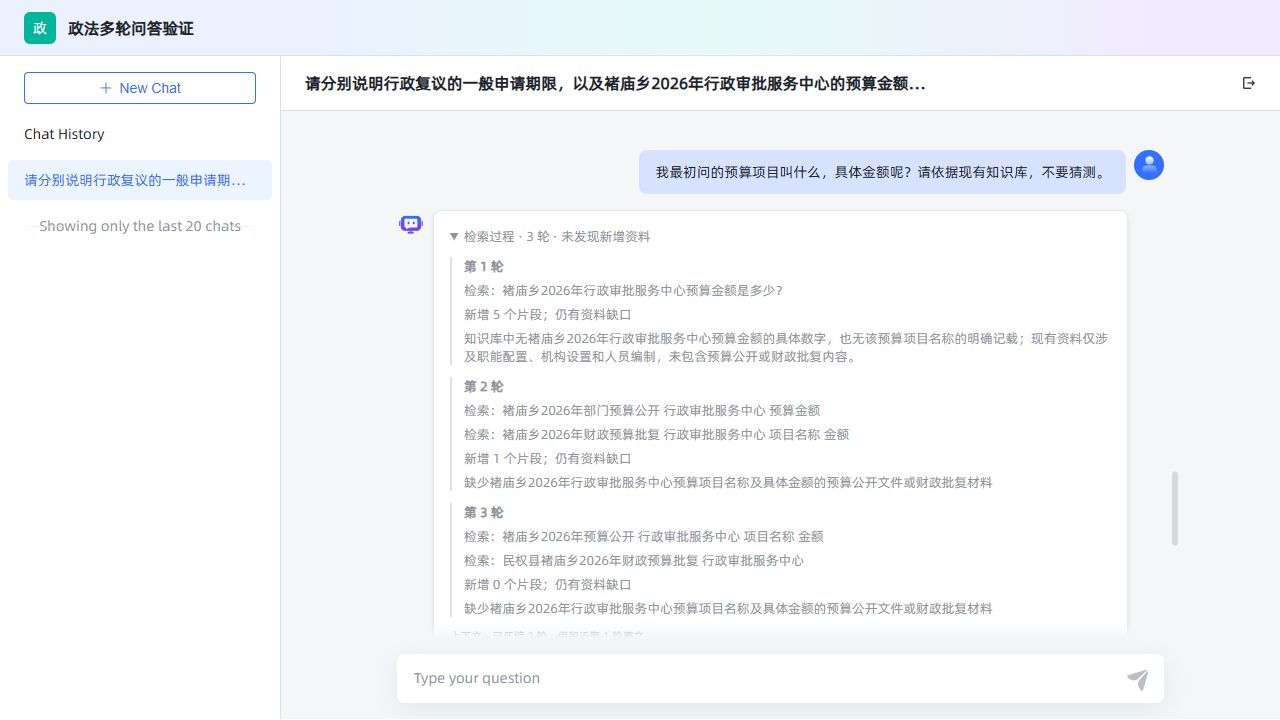
长会话要么丢信息,要么烧 token。MossKB 用一个明确阈值来决策。
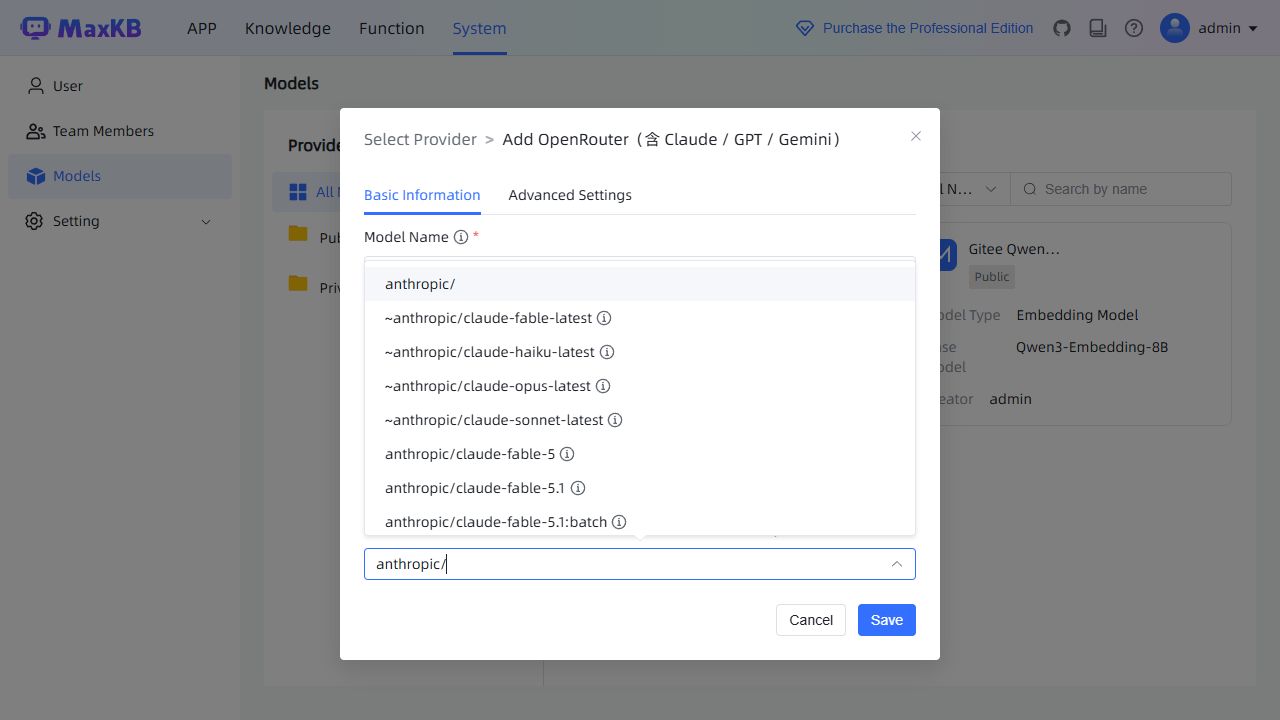
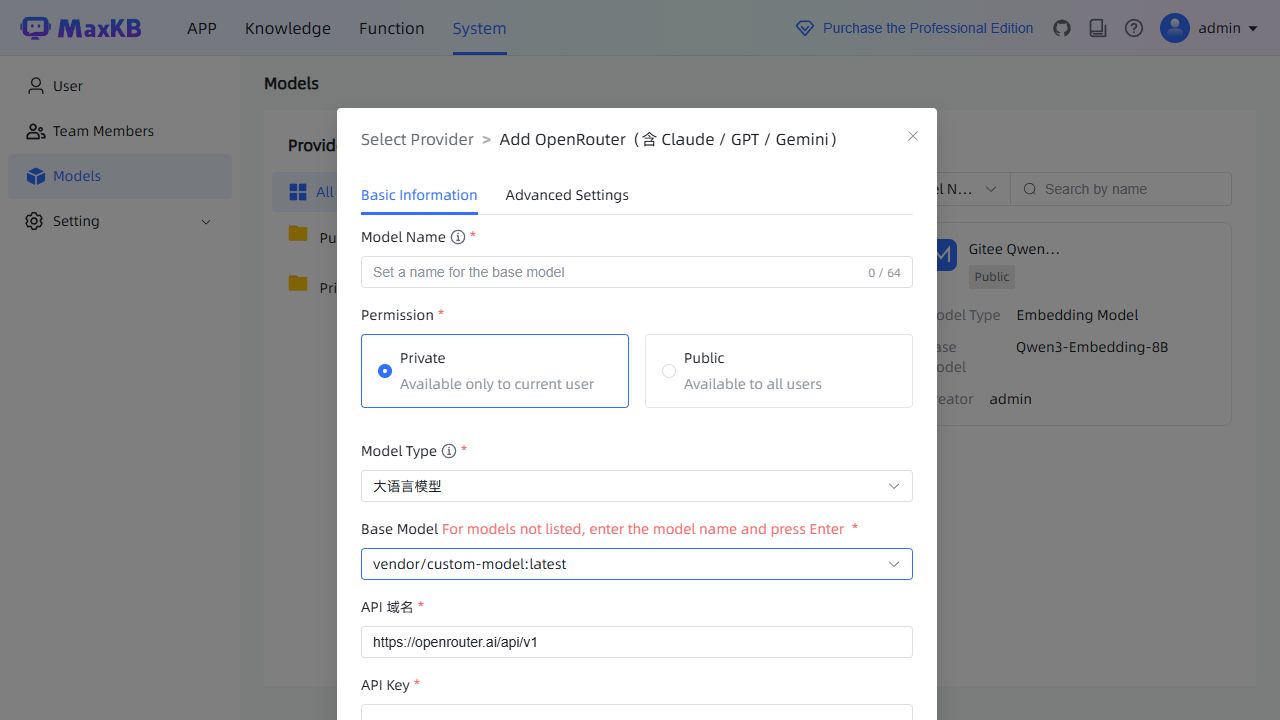
平台信息、候选模型目录与用户创建的模型实例分开存放,运行时不再读固定供应商配置文件,改目录不需要重新编译。
| 用途 | 默认模型 |
|---|---|
| 最终回答 / 改写 / 核验 / 摘要 | deepseek-v4.1-flash(Gitee 兼容接口) |
| 向量检索 | Qwen3-Embedding-8B,1024 维 |
| 扫描页与图片 OCR | PaddleOCR-VL-1.5(异步文档解析) |
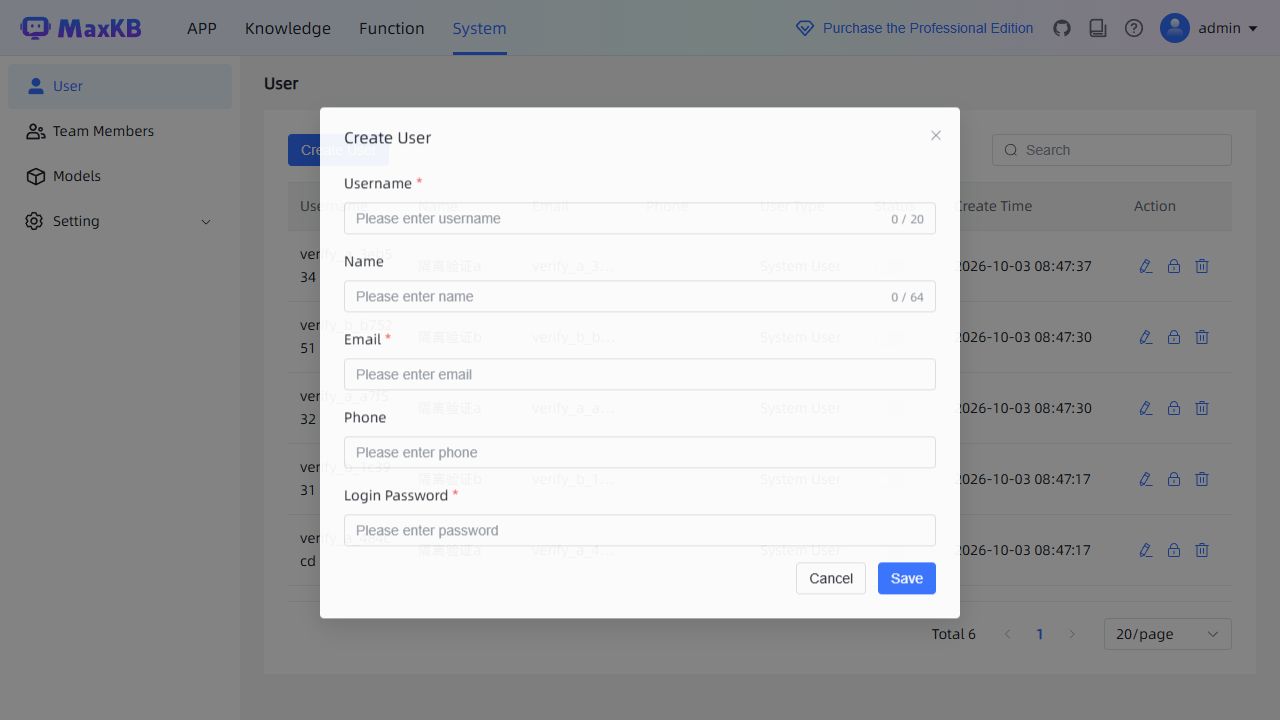
一个实例可以给多个团队用,但彼此看不到对方的资料。
需要数据库与进程也完全独立时,应分别部署实例,而不是依赖账号隔离。
函数库里的代码需要真的执行,但不能因此把服务器交出去。执行器有两种实现,由配置选择,默认 Docker。
| runner | 适用环境 | 隔离方式 |
|---|---|---|
docker(默认) |
Windows 与 Linux;引擎可在本机,也可在局域网内已装 Docker 的主机 | 一次性容器:断网、只读根文件系统、非 root、内存 / CPU / pids 上限、tmpfs |
host |
Linux(含容器内部署),不需要 Docker | runuser 切到沙箱用户 + 独立目录 + 白名单环境变量;不断网、无只读根、无资源上限 |
访客按公开访问链接上配置的当日次数限制提问,超出后由运营在后台调整。
<iframe
  src="https://cloud.mosskb.cn/ui/#/chat/<应用令牌>"
  style="width:100%;height:100%;border:0"
  allow="microphone">
</iframe>
令牌与显示设置由应用概览维护,重置令牌后需要重新嵌入。
后端只负责编排与存储;模型权重、OCR 与向量都可以是远程服务,本机需要的只是 JDK、PostgreSQL 和可选的 Docker 客户端。
Windows 与 Linux 提供同名脚本,数据库初始化脚本是幂等的,可以在已有数据库上重复执行。
| 依赖 | 说明 |
|---|---|
| JDK 21 | 后端运行环境 |
| Maven | 构建后端 |
| Node.js / npm | 构建前端 |
| PostgreSQL | 需要安装 pgvector 与 pg_trgm 扩展 |
| Docker(可选) | 仅隔离 Python 执行功能需要,不必装在本机 |
# 1. 初始化数据库(幂等,可重复执行)
.\scripts\Initialize-Database.ps1

# 2. 构建并启动后端与前端
.\scripts\Start-Local.ps1 -Build

# 3. 跑回归测试
mvn test

# 4. 部署后冒烟检查
.\scripts\Test-Deployment.ps1 -PostgresBin 'D:\Program Files\PostgreSQL\18\bin'
Linux 与 WSL 使用 ./scripts/Initialize-Database.sh、./scripts/Start-Local.sh --build。前端默认在 http://localhost:3000/ui/,接口在 http://localhost:10060/api。
不必须。聊天模型、向量模型与 OCR 都可以指向远程服务,本机只需要 Java 运行时与 PostgreSQL。反过来,如果要求完全离线,也可以替换为自建的推理与向量服务,配置项与接口都留好了。
可以。初始化脚本会建立扩展、业务表、索引与外键,并补齐旧库缺少的列,可以重复执行。需要清空重建时才加 -Reset,它会先删除业务表。升级前请先备份。
extension "vector" is not available 怎么办?这表示缺失的是扩展的二进制文件,而不是 SQL。需要在实际运行 PostgreSQL 的机器上安装 pgvector 的文件,再连接业务数据库启用扩展;只执行 SQL 无法安装缺失的二进制。
新建知识库时可以选。已有文档的知识库不能直接切换向量空间,因为维度与向量分布都变了,需要新建知识库并重新导入文档。默认向量模型返回 1024 维。
MossKB 是独立的 Java 实现,前端基于官方界面并保留必要定制。后端、数据库结构与接口都以 Java 技术栈重新实现,部署方式与运行依赖与上游不同,文档与部署脚本请看本项目仓库。
统计分析、向量库的其它替代方案、以及完整的工作流编排能力尚未全部实现;界面上有菜单或文档里有设计示例,都不代表已经可用。这一页只列已经跑通的功能。